成都先导的化学业务秉持高质量、高效率及持续创新的理念,为全球合作伙伴提供有效、灵活及具竞争力性价比的化学解决方案,以推动药物研发和创新化学产品的突破。
计算化学与信息学
计算化学基于物理学的算法和计算机来模拟化学事件并计算原子和分子的化学性质,从而加速漫长而昂贵的药物发现过程。 成都先导计算科学团队包括来自生物信息学、化学信息学、计算机辅助药物设计(CADD)和人工智能辅助药物发现(AIDD)的专家,他们可以在药物研发的各个阶段提供一系列服务来支持您的药物发现项目。
针对靶点的可行性分析贯穿于早期靶点提名及中后期先导化合物发现阶段。一个可行度高的靶点会从以下几个方面进行详细评估。
· 通过综合性的文献调研以获得对靶点的足够理解。此阶段会评估靶点是否有足够生物学证据证明其与疾病直接相关,作为靶点的作用机制,以及是否有可靠的生物评价手段等。
· 市场及竞品综合性调研,与其他产品的差异化是此阶段强调的重点。
· 成都先导拥有多个新药发现平台,包括但不限于DNA编码化合物库平台、基于片段/结构的药物发现平台(FBDD/SBDD)、计算机辅助药物设计平台(CADD)以及小核酸药物平台。
成都先导凭借在库设计领域的深厚专业积累以及持续增长的化合物结构信息资源,为您的药物开发项目打造了一个强大、可靠且独具特色的化合物库。借助前沿的算法和顶尖的云计算资源,我们能够以快速、高效且经济实惠的方式,帮助您精准识别苗头化合物,加速药物研发进程。
超大数据库与多维筛选:
依托超大规模的商业化合物数据库(涵盖超过80亿种结构)以及自主构建的超大化合物集合(超过1万亿种结构),我们运用多种类药过滤器、子结构检索及相似性搜索技术,能够迅速从海量数据中锁定具有潜力的候选分子。
AI生成与扩充化合物库:
结合多种前言生成式预训练模型和图神经网络,自动生成结构新颖、具备类药性的分子,同时采用骨架跃迁和虚拟扩展技术覆盖更广化学空间。
基于受体结构的虚拟筛选:
我们具备针对广泛靶点类型的虚拟筛选能力,涵盖激酶、GPCR、磷酸酶、PPI等多种重要生物靶标。在基于受体结构的虚拟筛选方面,不仅充分利用现有的结构数据,还具备通过AI技术构建和优化受体模型的能力。即使在靶点结构信息有限的情况下,也能确保筛选的精准性。
基于配体的虚拟筛选:
对于缺乏完整受体结构信息的靶点,我们采用基于配体的虚拟筛选方法,通过构建精准的药效团模型和分子嵌入技术,实现高效识别潜在候选分子,进一步扩展筛选范围和提升命中率。
多平台高性能计算支持:
整合了超算中心与本地高性能计算资源,实现了从分子筛选、分子对接到ADMET预测的全流程加速,确保了虚拟筛选过程的高效运行。
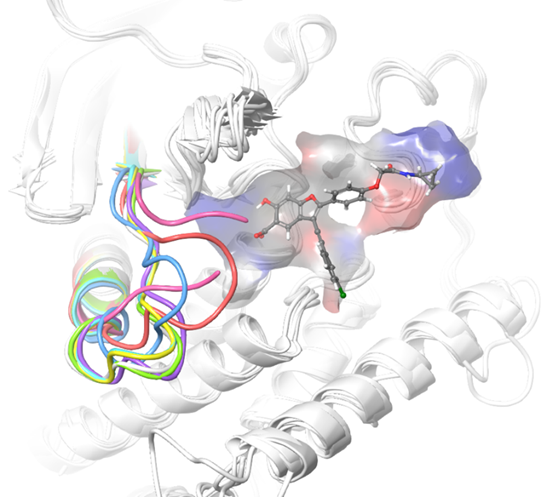
成都先导拥有一支经验丰富的计算科学团队,采用基于结构的药物设计技术,助力药物发现项目的全流程研发。我们依托先进的AI驱动方法和多尺度计算技术,实现精准的小分子结合模式预测、基于受体结构引导的小分子生成和FEP自由能计算,并在复杂体系建模及基于片段药物设计等领域拥有深厚的技术实力。
蛋白共晶服务及模型的AI预测
我们提供专业的蛋白共晶实验服务,并结合AI驱动技术对蛋白共晶模型进行预测。通过分子动力学和AI辅助的柔性靶标采样,捕捉受体在不同状态下的构象变化,为后续药物设计提供更丰富的动态结构信息。
先进的小分子结合模式预测
我们实现了多种分子对接策略,包括共价对接、量子力学(QM)对接、诱导契合对接等,以适应多样化的结合场景。同时,借助3D-CNN对接重打分系统和多种基于AI的预测模型,确保对接结果具备更高的准确性和可靠性,提供精准的结合模式预测。
基于受体结构的小分子生成
依托受体的结构特征,我们利用AI生成模型和骨架跃迁技术,自动设计出符合受体结合位点要求的新型小分子,为药物创新提供多样化候选分子。
FEP计算服务
我们提供基于自由能微扰(FEP)理论的计算服务,通过增强采样算法和高精度模拟,准确评估蛋白与配体之间的结合亲和力,有效指导先导化合物的优化。经验证,我们的FEP计算服务平均绝对误差(MAE)约为1.0 kcal/mol,显著降低了实验验证阶段的成本和时间。
复杂体系建模
针对复杂生物体系,我们具备构建和分析多体相互作用的能力,包括PROTAC三元复合物建模、蛋白-蛋白对接及蛋白-核酸复合体建模,满足不同药物设计需求。
基于片段药物设计
通过采用片段筛选与生长策略,我们能从低亲和力片段中发现关键结合热点,随后结合结构优化和人工智能方法,实现从片段到先导化合物的高效转化。
在药物发现项目中,即使在缺乏靶蛋白结构信息的情况下,我们依然能够借助先进的基于配体的药物设计技术,为项目提供高效且精准的支持。我们的核心能力主要体现在以下几个方面:
DEL+AI 助力活性分子发现
借助DEL技术构建的海量化合物库,结合AI在海量数据中迅速筛选出高生物活性候选分子的能力,我们能够建立结构—活性关系模型,精准预测化合物的生物活性,并为后续的设计与合成提供科学指导。
智能相似性搜索与聚类
依托自有的超大化合物库(覆盖万亿级化合物)以及丰富的数据挖掘经验,我们融合AI技术实现了高效的相似性搜索与聚类优化。此举不仅大大加速了潜在活性化合物的筛选过程,也为后续的结构分析打下了坚实基础。
精准药效团模型构建与结构优化
基于已知配体的2D和3D结构数据,我们能够构建精准的药效团模型,为新化合物提供有效的结构评估,并通过模型优化进一步提升预测的准确性。
新颖化合物设计
通过内部自建或商业化的骨架跃迁方法,我们针对性质不佳的化学结构进行改造,从而生成具有高附加值的新IP化合物,为候选药物的开发注入更多创新可能。
数据驱动的活性与ADMET预测
利用内部开发的AI驱动的ADMET与QSAR预测平台,结合海量实验数据与化学信息学模型,我们能够高效预测新化合物的生物活性、毒性及ADMET属性。依托数据反馈与强化学习不断迭代优化,我们显著提高了预测准确率,减少了后续研发流程的工作量,从而节省了大量资源和时间。
量子力学与分子动力学的深度融合
通过基于量子力学的结构优化与分子动力学的构象分析,我们能够准确预测化合物的稳定构象及柔性变化,深入揭示化合物与靶标之间的结合模式。
在实际研发过程中,我们常将基于配体的药物设计与基于结构的药物设计有机融合,贯穿于项目的各个阶段。多项前沿技术的协同应用已在多个项目中取得显著成果,充分展示了我们的综合研发实力。
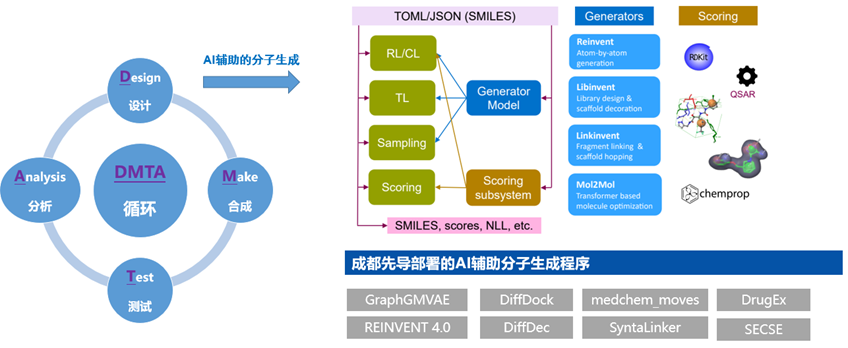
在药物研发领域,人工智能(AI)驱动的分子生成技术正以前所未有的速度加速新药的发现和优化。成都先导积极部署并应用多种AI分子生成程序,涵盖多种技术方法,展现了卓越的能力和广泛的应用场景。
与腾讯合作开发骨架跃迁算法:
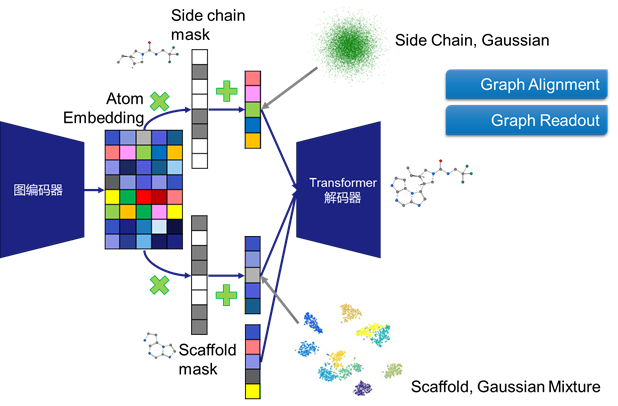
成都先导与腾讯AI Lab合作,共同设计开发了分子骨架跃迁算法(GraphGMVAE)。该算法能够在保持分子侧链不变的情况下,生成具有相似生物活性但不同骨架的分子。在内部激酶项目中,应用该平台获得了与参考化合物活性相当(<10nM)但具有新专利空间的化合物系列,充分验证了平台的能力。
多元化的分子生成程序部署
为了满足不同的研发需求,成都先导部署了超过10种分子生成程序,涵盖随机生成、骨架跃迁、R集团替换、片段连接、虚拟化合物库生成以及基于受体结构的化合物生成等多种技术方法。这些程序的应用,显著提升了我们在新药发现和优化过程中的效率和成功率。
成都先导依托先进的计算模拟技术与丰富的实验数据积累,打造了一体化的AI驱动ADMET预测平台。该平台可在化合物筛选与优化过程中提供高效、精准的成药性评估,助力加速药物研发,降低研发风险,提高候选化合物的成功率。
多维度ADMET属性预测
我们的AI模型可精准预测化合物的关键ADMET特性,包括:
1) 吸收与分布:血脑屏障通透性(BBB)、血浆蛋白结合率(PPB)、口服生物利用度等;
2) 代谢与转运:基于细胞色素P450(CYP)酶系的代谢稳定性预测、转运体介导的摄取与排泄评估;
3) 毒性预测:肝毒性、心脏毒性(hERG抑制)等多个关键安全性指标。
该平台可为早期药物筛选提供全面、系统的成药性评估,助力候选化合物的筛选与优化。
自适应AI建模与项目定制优化
我们基于内部研究项目及公开数据库的持续数据反馈,不断优化ADMET AI模型,确保预测结果的高精准度。针对特定靶点或项目需求,可进行个性化建模,提高化合物优化的针对性和成功率,为项目团队提供更具针对性的决策支持。
高通量计算赋能大规模筛选
依托超算中心及本地高性能计算资源,我们实现了ADMET预测的高通量并行计算,能够在短时间内完成大规模化合物库的成药性评估,为药物研发提供快速、精准的数据支持。
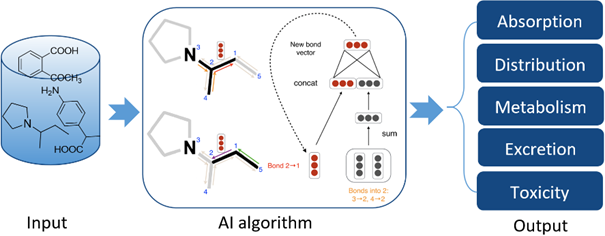
成都先导部署了一系列商业和开源的化学信息学工具来支持数据驱动的项目决策。作为领先的先导化合物发现平台,我们建立了一系列功能版块来支持DNA编码化合物库构建和筛选,包括分子骨架和试剂片段的选择,库化合物的设计、库合成、库选择以及富集化合物的挑选和先导化合物的优化工作。
· 完善的化学信息学工作流程,可进行数据驱动的骨架和片段的选择
· 各种化学信息学多样性和类药性表征手段,例如理化性质计算,指纹聚类和多样性分析,用以现有库化学和新设计的化合物库的空间的覆盖度以及类药性评估
· 超大型库(>〜1012)的结构枚举和存储、子结构和相似性结构检索以及类药性评估
· 结合人工智能技术和库合成和筛选中的实验信息,提高DEL找到活性化合物的命中率
· 数据和结构驱动的DNA编码化合物中的富集特征识别和后续重合成化合物的推荐
· 利用DEL筛选数据训练QSAR模型,预测DEL化学空间以外的化合物的结合力或活性
 川公网安备 51012202000492号